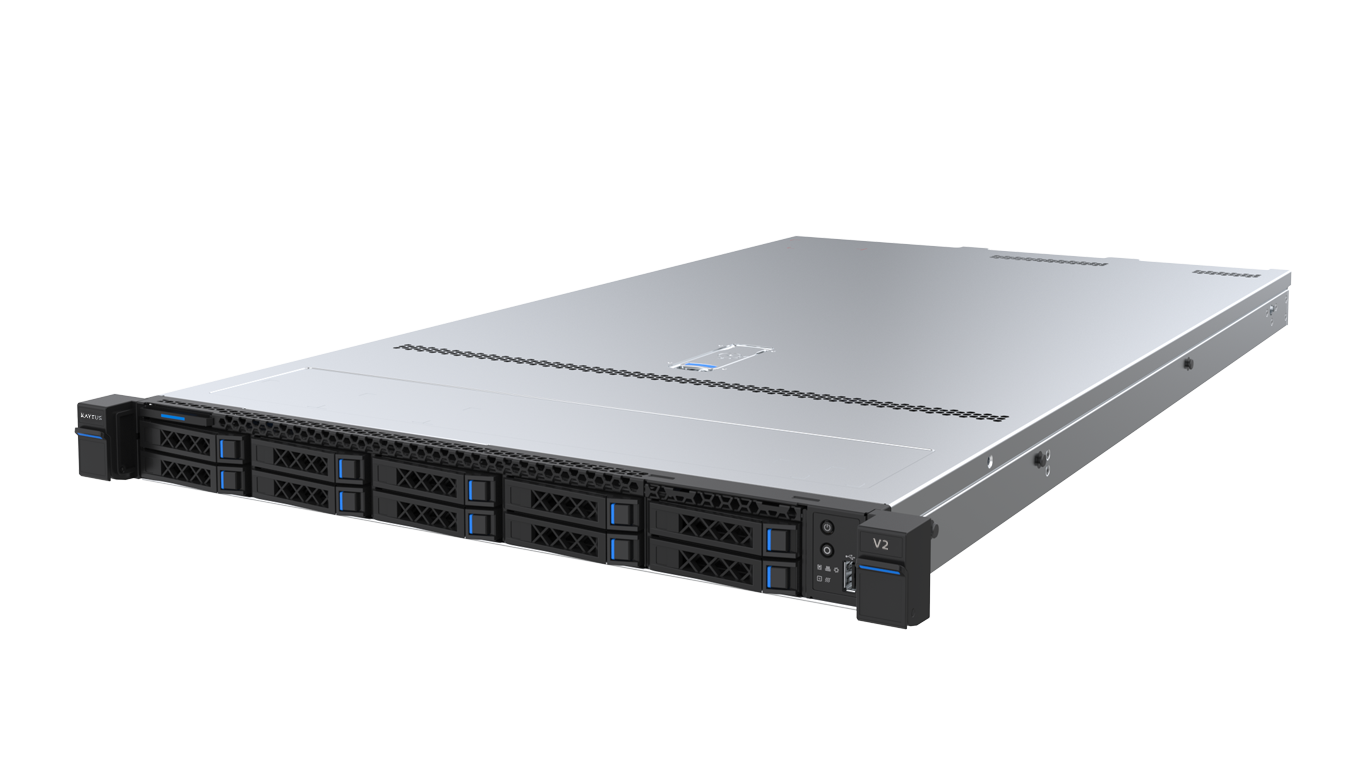
Basierend auf den Serverplattformen KR2280 und KR1180, ist die Lösung tief in branchenführende, KI-basierte parallele Dateisysteme integriert und beseitigt so Datensilos, die bei herkömmlichen mehrstufigen Speichersystemen üblich sind. Sie wurde speziell für leseintensive KI-Workloads entwickelt und überwindet die horizontalen Skalierungsgrenzen massiver Cluster. Verifizierte Testdaten zeigen, dass die Lösung bei einer Bereitstellung im Exabyte-Bereich eine aggregierte Bandbreite von 10 TB/s und 100 Millionen IOPS (Input/Output Operations Per Second) liefert. Darüber hinaus senkt sie die Gesamtbetriebskosten (TCO) über fünf Jahre um 70 Prozent im Vergleich zu herkömmlichen TLC-basierten Lösungen (TLC = Triple Level Cell) und beschleunigt so die Modellinnovation für KI-Cloud-Anbieter und intelligente Rechenzentren.
Limitierungen herkömmlicher KI-Speicherarchitekturen
Das explosive Wachstum der KI verändert die Anforderungen an die Rechen- und Speicherleistung in Unternehmen grundlegend. Das Training groß angelegter KI-Modelle ist durch extrem leseintensive Workloads gekennzeichnet, die den gleichzeitigen Zugriff Zehntausender von GPUs auf Datensätze im Exabyte-Bereich mit einer Latenz von unter einer Millisekunde erfordern. Herkömmliche Speicherarchitekturen stehen dabei vor großen Herausforderungen wie getrennte Datensilos, Diskrepanz zwischen Workload und Speichermedium sowie Skalierungsengpässe.
Getrennte Datensilos
Herkömmliche ETL-Prozesse (ETL = Extract, Transform, Load) erfordern, dass Daten vor dem Training vom Objektspeicher in parallele Dateisysteme verschoben werden, was zu einer zeitaufwändigen physischen Datenmigration führt. Untersuchungen von IDC zeigen, dass Datenteams 81 Prozent ihrer Zeit mit der Datenaufbereitung verbringen, was die Geschäftsprozesse verlangsamt.
Diskrepanz zwischen Workload und Speichermedium
Mehr als 90 Prozent des KI-Trainings beinhalten hochfrequente gleichzeitig stattfindende Lesevorgänge. Im Gegensatz dazu bieten herkömmliche TLC-Flash-Lösungen eine übermäßige Schreiblebensdauer, die für diese leseintensiven Workloads unnötig ist. Dies treibt die Anschaffungs-, Platz- und Stromkosten für Cluster im Exabyte-Bereich in die Höhe und führt zu einer ineffizienten Ressourcennutzung.
Skalierungsengpässe
Herkömmliche Dateisysteme wurden nicht für die Bewältigung der durch Cluster mit 10.000 GPUs erzeugten I/O-Spitzenlasten konzipiert. Mit zunehmender Clustergröße führen Konflikte bei der Sperrung von Metadaten und ein vergrößerter Kommunikationsaufwand zu Latenzspitzen und einer Verschlechterung der Gesamtleistung.